ენა

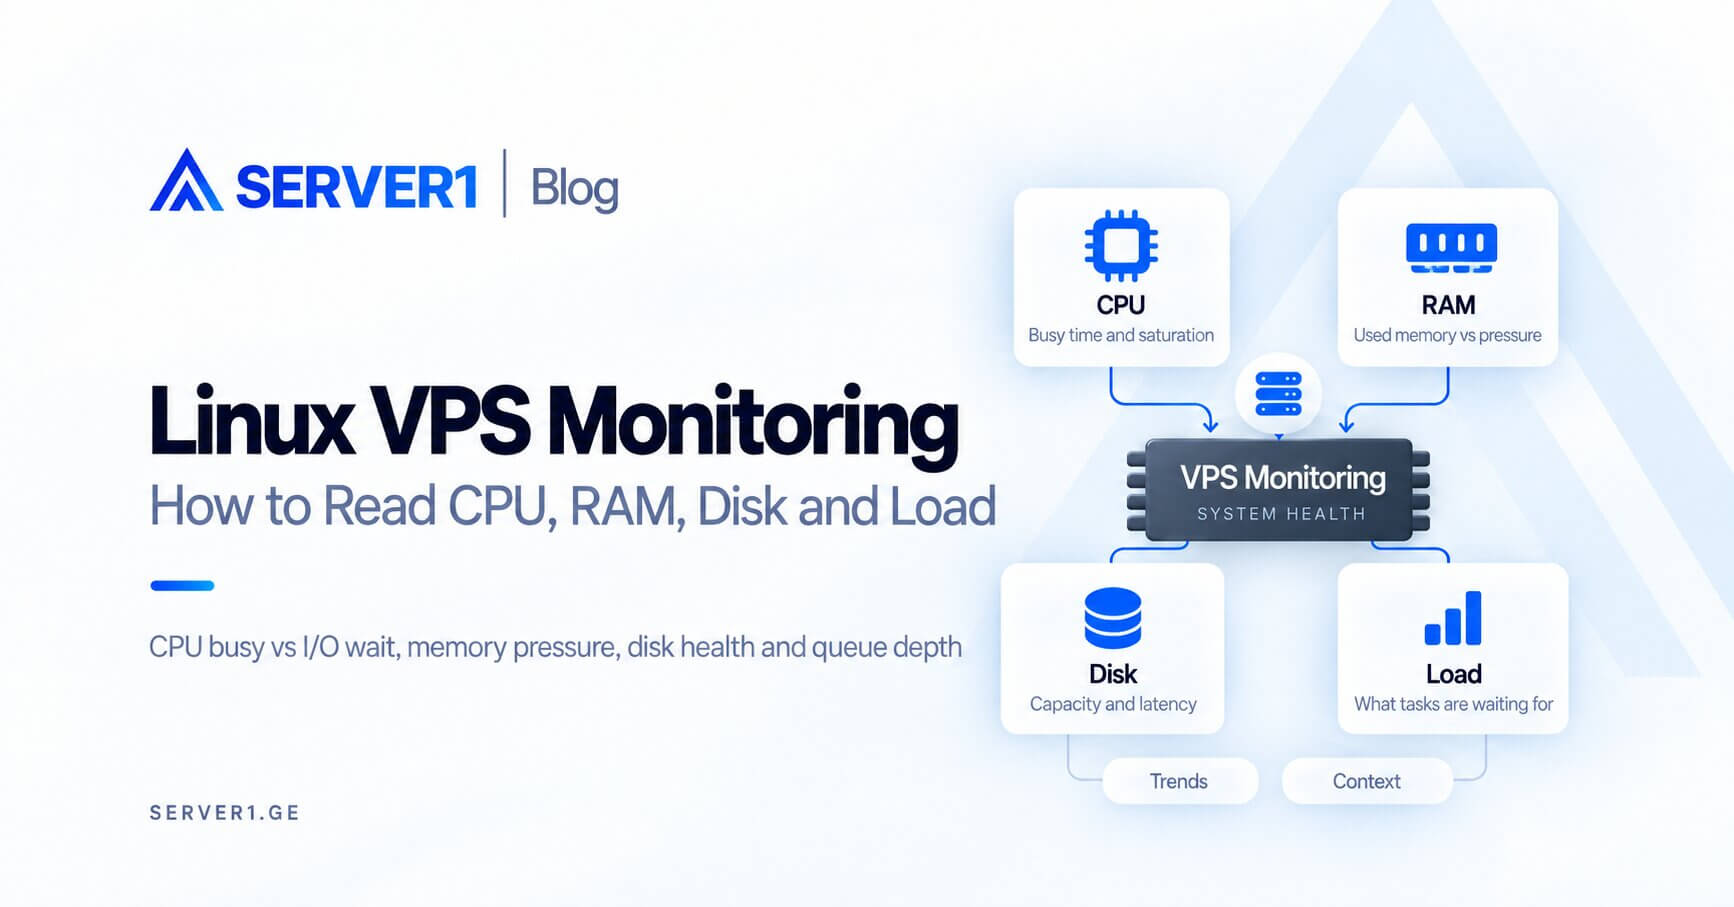
Linux VPS monitoring-ის მიზანი არ არის რაც შეიძლება მეტი graph-ის დაგროვება. უნდა იცოდეთ ოთხი რამ: CPU რეალურად დაკავებულია თუ processes I/O-ს ელოდება, RAM-ში pressure არის თუ უბრალოდ page cache, disk capacity/latency ნორმაშია თუ არა, და load average რა ტიპის queue-ს ასახავს.
5-წუთიანი health check
| Metric | რას ვკითხულობთ | საწყისი ინსტრუმენტი |
|---|---|---|
| CPU | busy, steal, iowait? | `top`, `mpstat` |
| RAM | available, swap, OOM? | `free -h`, `/proc/meminfo` |
| Disk | capacity, inode, latency? | `df`, `iostat` |
| Load | runnable/I/O-wait jobs? | `uptime`, `/proc/loadavg` |
Load average CPU percentage არ არის
Linux load average 1/5/15 წუთზე runnable tasks-ს და uninterruptible disk-I/O wait-ში მყოფ tasks-ს აჯამებს. ამიტომ load 4 არ ნიშნავს ავტომატურად “CPU 400%”. 4-vCPU VPS-ზე load 4 შეიძლება სრულიად განსხვავებულად გამოიყურებოდეს, თუ CPU 95% busy-ა, ან CPU თავისუფალია და tasks disk-ს ელოდება.
RAM: “free” დაბალია - ეს ჯერ პრობლემა არაა
Linux თავისუფალ RAM-ს page cache-ად აქტიურად იყენებს. უფრო საინტერესოა `available`, swap activity და OOM signals. თუ memory pressure-ისას swap მუდმივად მოძრაობს, ნახეთ Swap VPS-ზე დეტალური გზამკვლევი.
Disk: capacity და latency ორივე საჭიროა
- `df -h` - filesystem fullness;
- `df -i` - inode exhaustion;
- `iostat`/latency metrics - storage queue და response;
- logs - filesystem errors ან application write failures.
Async workload-ის დროს disk/DB pressure განსაკუთრებით შეიძლება background jobs-მა შექმნას; იხილეთ background workers-ის სტატია.
Alert threshold ერთი ციფრი არ არის
“CPU > 80%” alert კონტექსტის გარეშე ხმაურია. უკეთესია duration + symptom: CPU > 90% 10 წუთი და p95 latency იზრდება; disk > 85% და ზრდის ტემპი მაღალია; available memory დაბალია და swap-in/out აქტიურია.
Baseline სანამ incident მოხდება
- ჩაიწერეთ ნორმალური CPU/RAM/disk/load სამუშაო დღეს;
- ცალკე დაინახეთ peak საათი;
- დააფიქსირეთ deployment/backup window;
- შეინახეთ მინიმუმ რამდენიმე კვირის trend;
- alert-ს owner და first action დაუწერეთ.
სერვერის მართვის ინსტრუმენტების სტატია monitoring-ს security/operations კონტექსტში აყენებს, ხოლო downtime-ის სტატია ხსნის რატომ უნდა უკავშირდებოდეს alert ბიზნეს გავლენას.
Unmanaged VPS-ზე monitoring/runbook მთლიანად თქვენი პროცესია; რესურსების ზოგადი არჩევისთვის ნახეთ SERVER1 VPS.
კარგი monitoring გეუბნებათ არა მხოლოდ “რიცხვი მაღალია”, არამედ “რა ზიანდება, რატომ და რა უნდა შევამოწმოთ შემდეგ”.
თუ მომხმარებელი Cloudflare 522-ს ხედავს, რესურსების მაჩვენებლები შეცდომის ზუსტ დროს შეადარეთ. ჩვენი 522 კავშირის შეფერხების დიაგნოსტიკა დაგეხმარებათ მონიტორინგის მონაცემების DNS-სა და ქსელის მტკიცებულებებთან დაკავშირებაში.