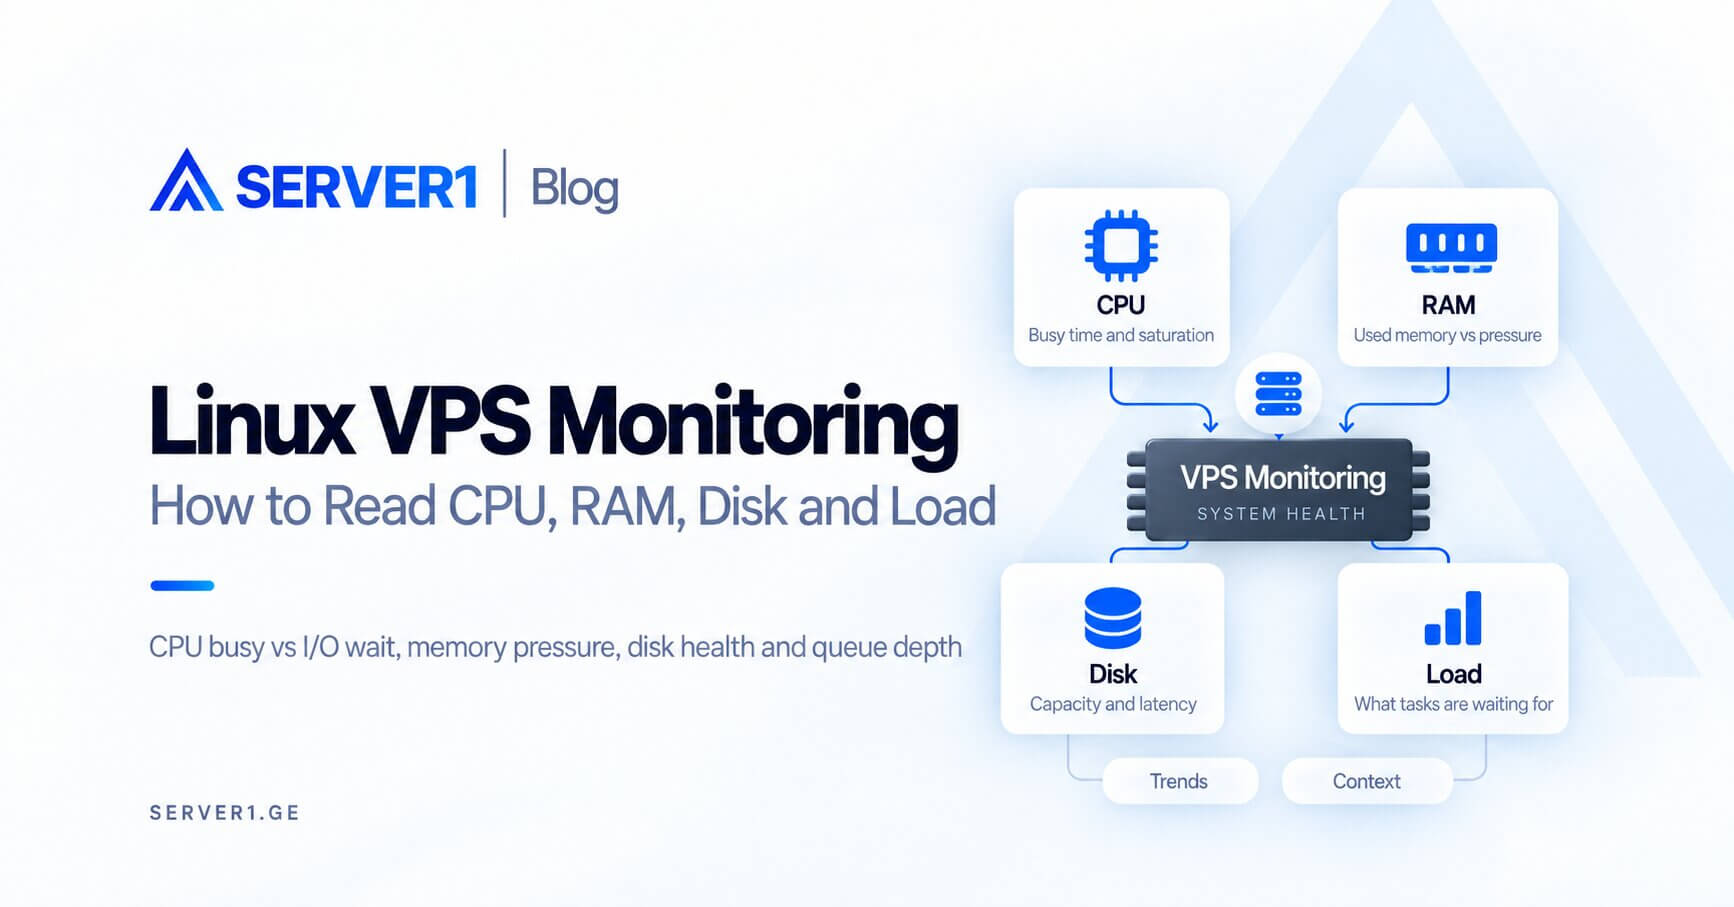
Цель Linux VPS monitoring - не собрать максимальное число графиков. Нужно понимать CPU, RAM, disk и load в контексте workload.
Пятиминутный health check
| Metric | Вопрос | Tool |
|---|---|---|
| CPU | busy, steal, iowait? | `top`, `mpstat` |
| RAM | available, swap, OOM? | `free -h` |
| Disk | capacity, inodes, latency? | `df`, `iostat` |
| Load | runnable/I/O wait? | `uptime` |
Load average - не CPU percentage
Load average учитывает runnable tasks и tasks, ожидающие disk I/O. Load 4 на 4-vCPU может означать разные проблемы.
Мало free RAM не всегда проблема
Linux использует RAM как page cache. Смотрите available, swap и OOM. При активном swap читайте гайд по swap на VPS.
Disk: capacity и latency
- `df -h`;
- `df -i`;
- `iostat`;
- logs.
Background jobs могут создавать spikes - см. background workers guide.
Alert - не один threshold
Лучше объединять duration и symptom, а не просто CPU > 80%.
Baseline до incident
- нормальные CPU/RAM/disk/load;
- peak часы;
- deployment/backup windows;
- trend history;
- owner и first action для alert.
Смотрите server management tools и downtime guide. На Unmanaged VPS monitoring ваш, для ресурсов смотрите SERVER1 VPS.
Хороший monitoring объясняет не только что metric высокий, но и что от этого страдает.