Idioma

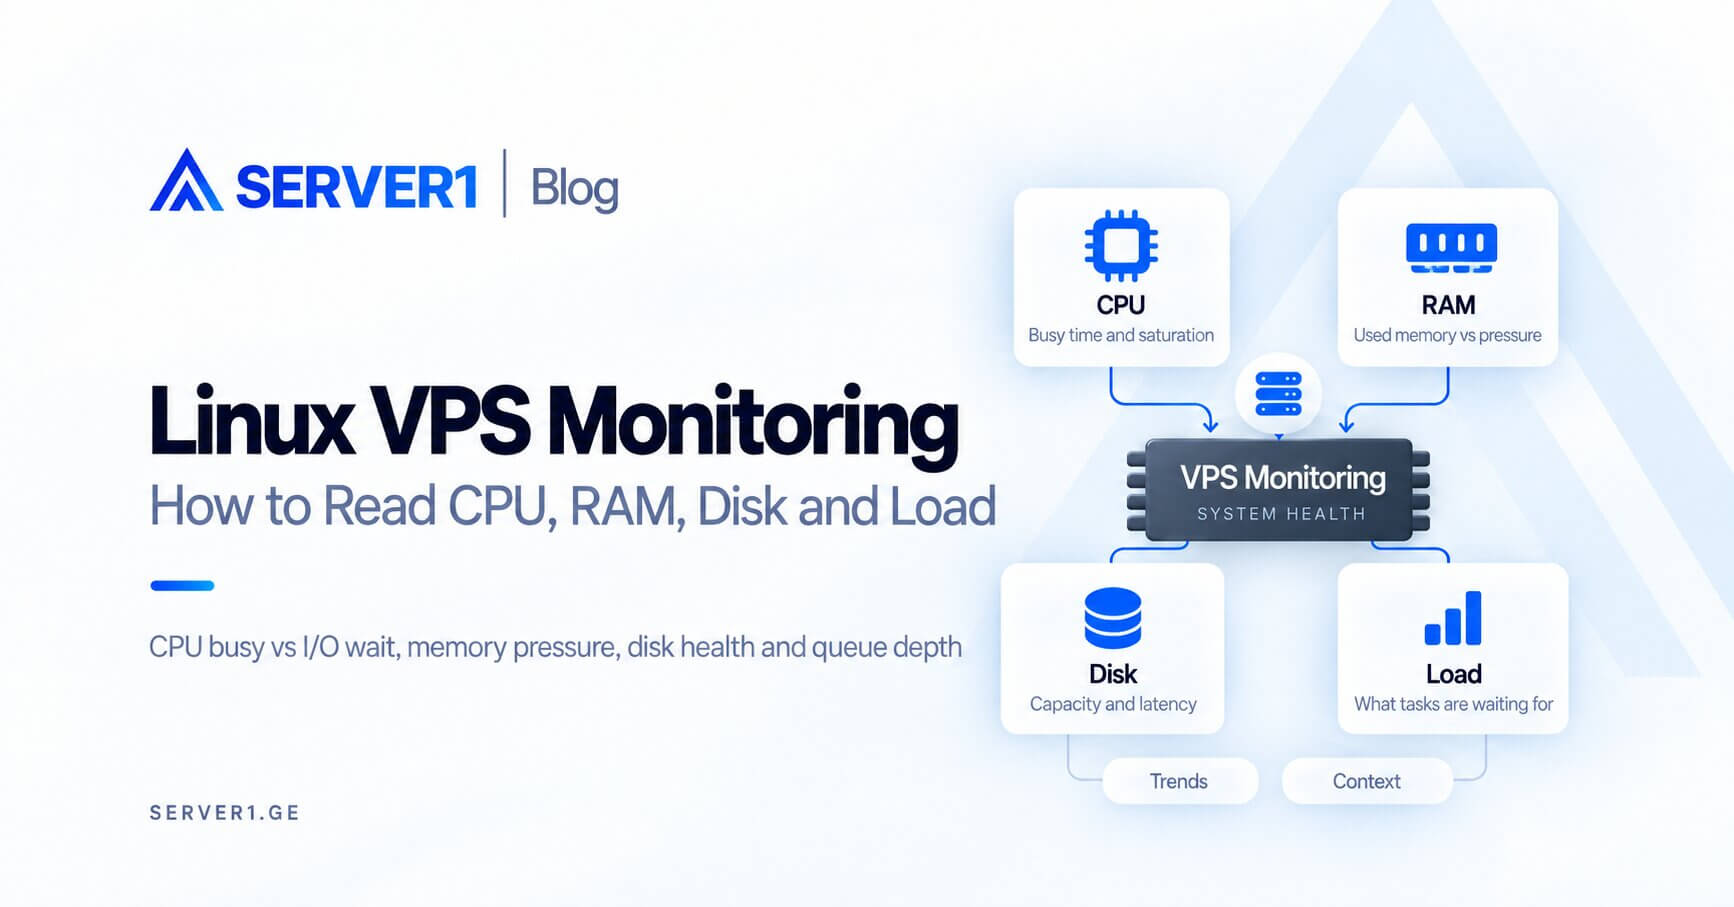
El objetivo del monitoring en un Linux VPS no es coleccionar gráficos. Debes entender CPU, RAM, disk y load en el contexto del workload.
Health check de cinco minutos
| Metric | Pregunta | Tool |
|---|---|---|
| CPU | busy, steal, iowait? | `top`, `mpstat` |
| RAM | available, swap, OOM? | `free -h` |
| Disk | capacity, inodes, latency? | `df`, `iostat` |
| Load | runnable/I/O wait? | `uptime` |
Load average no es porcentaje de CPU
Load average incluye tasks runnable y tasks esperando disk I/O. Un load 4 en un VPS de 4 vCPU puede significar situaciones muy diferentes.
Poca RAM “free” no siempre es un problema
Linux utiliza memoria como page cache. Observa available, swap y OOM. Si swap está activo constantemente, consulta la guía de swap en VPS.
Disk: capacidad y latency
- `df -h`;
- `df -i`;
- `iostat`;
- logs.
Background jobs pueden provocar picos; revisa la guía de background workers.
Un alert no debe ser un único threshold
Combina duración y síntomas en lugar de usar solo CPU > 80%.
Construye un baseline antes del incident
- CPU/RAM/disk/load normales;
- horas peak;
- deployment/backup windows;
- trend history;
- owner y first action por alert.
Consulta server management tools y la guía de downtime. En VPS no administrado el monitoring es tu responsabilidad; para recursos revisa SERVER1 VPS.
Buen monitoring explica no solo que un metric está alto, sino qué se degrada y qué revisar después.
Si un visitante ve Cloudflare 522, compara el historial de recursos con la hora exacta del fallo. Nuestra guía de diagnóstico del timeout 522 relaciona el estado del servidor con las pruebas de DNS y red.