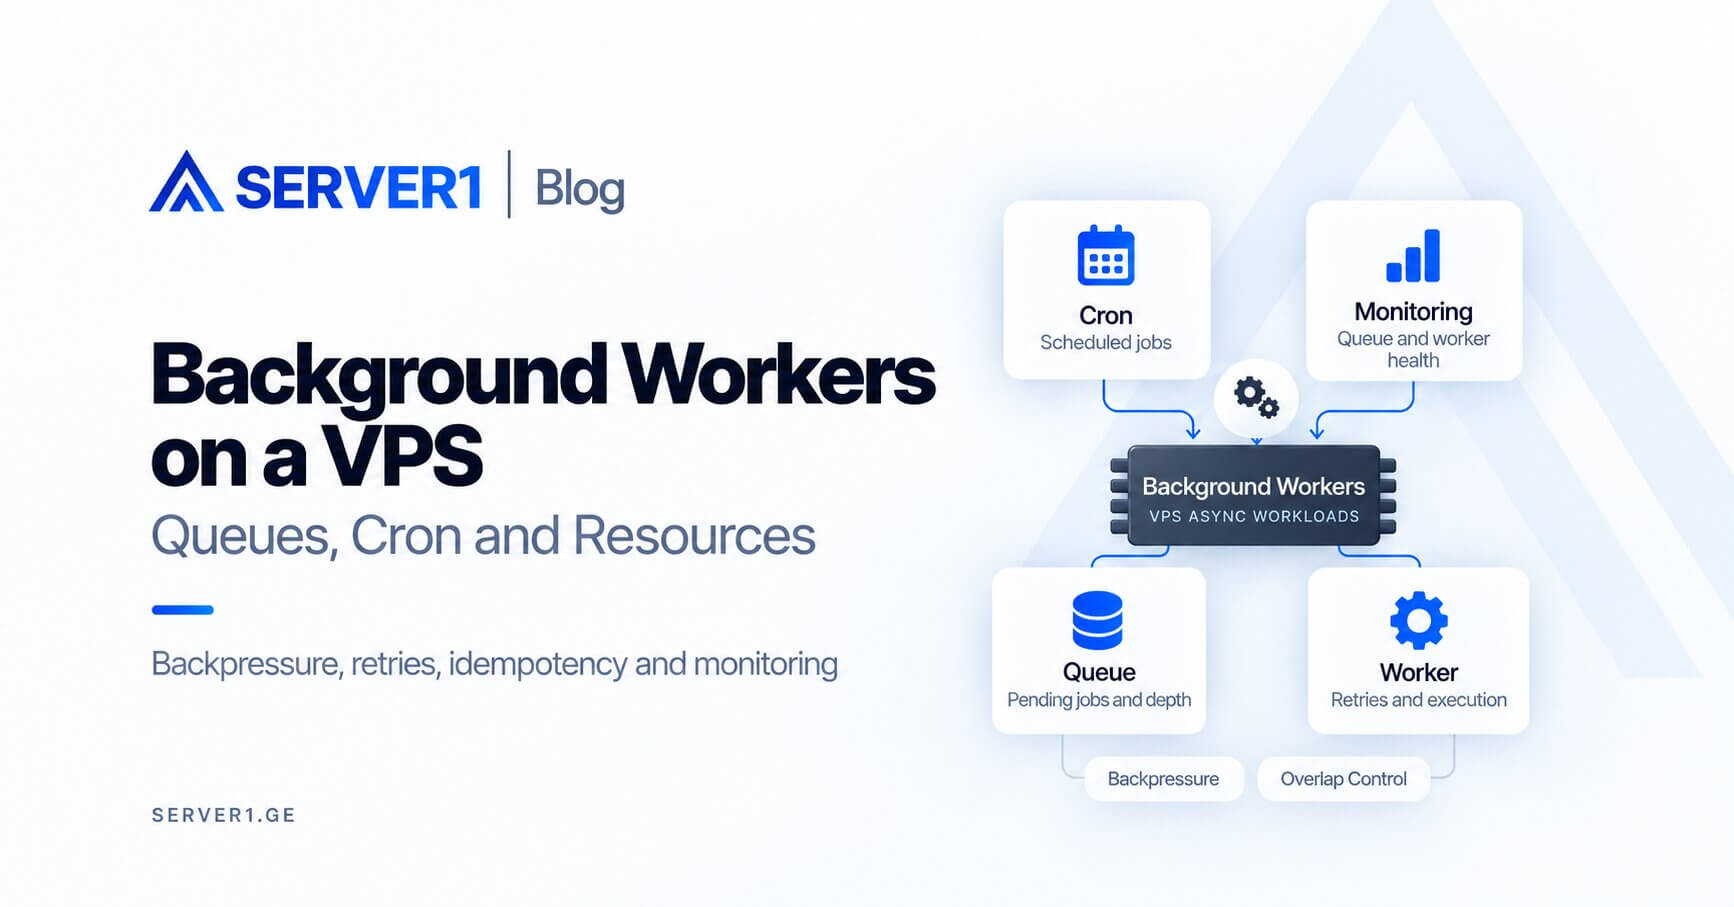
Los background workers y scheduled jobs encajan muy bien en un VPS, pero necesitan límites para no consumir los recursos de las requests del sitio. Un queue job pesado, un import grande o tareas cron solapadas pueden agotar CPU, RAM o database connections y ralentizar la web.
Web y Async son cargas diferentes
| Web request | Background job |
|---|---|
| el usuario está esperando | puede esperar en una queue |
| la latency es crítica | el throughput puede ser más importante |
| se prefiere ejecución corta | puede durar minutos |
Un worker necesita supervisor
Ejecutar un worker manualmente dentro de una SSH session no es production process management. Utiliza systemd, Supervisor o un process manager apropiado para reiniciar tras un crash y mantener logs de forma predecible.
la guía de hosting para Laravel ofrece un buen ejemplo de queue workers y scheduler. la guía sobre administración del servidor explica por qué monitoring y ownership son tareas continuas.
Tres fallos de cron que conviene evitar
- la ejecución anterior no ha terminado y ya comienza otra;
- el job no tiene timeout ni resource limit útil;
- el error llega al log pero no genera ningún alert.
Protege la carga visible para el usuario
- aumenta worker concurrency solo después de medir;
- programa imports grandes fuera de las horas de mayor tráfico;
- controla DB connection pools y limits;
- monitoriza queue depth y oldest-job age;
- diseña idempotency cuando haya retries.
¿Cuándo mover los workers a otro VPS?
Cuando la carga async crece de forma independiente, los jobs intensivos en CPU dañan la web latency o deployment y restart necesitan políticas distintas. Antes de eso, un solo VPS suele ser suficiente. Si tu equipo gestiona Linux directamente, VPS no administrado ofrece máxima flexibilidad.
La queue debe sacar trabajo pesado del request path, no trasladar el bottleneck a otro proceso dentro del mismo servidor.
Si quieres reducir la carga de on-call y process supervision, compara con Managed VPS. La lógica de los workers a nivel de aplicación seguirá siendo responsabilidad del código.
Backpressure: una queue no es un buffer infinito
Si los producers crean 1.000 jobs por minuto y los workers solo completan 600, la queue crecerá continuamente. Añadir workers sin más puede terminar sobrecargando la base de datos o una API externa. Hace falta backpressure: reducir producer rate, usar batches más pequeños o añadir capacity de forma deliberada.
Sin retry strategy, un error transitorio puede convertirse en incident
| Escenario | Mala reacción | Mejor enfoque |
|---|---|---|
| API temporalmente caída | immediate retry infinito | exponential backoff + retry limit |
| payload inválido | retry permanente | fail/dead-letter + investigación |
| payment-like operation | blind retry | idempotency key/state check |
| import grande | un job enorme | batches pequeños y reanudables |
Qué debería aparecer en el dashboard
- queue depth;
- edad del pending job más antiguo;
- jobs completados por minuto;
- failure/retry rate;
- CPU/RAM de workers;
- uso de database connections;
- external API latency si los jobs dependen de ella.
Scheduled jobs necesitan control de overlap
Si una tarea se ejecuta cada cinco minutos pero a veces tarda ocho, habrá ejecuciones solapadas sin un lock o una single-run policy. Lo mismo ocurre con backups, imports y report generation.
Cuándo merece la pena separar workers en otro VPS
- los picos de CPU de workers coinciden con mayor web latency;
- la carga async escala de forma independiente al tráfico web;
- el worker deployment cadence es distinto;
- los jobs necesitan otro security/network access;
- quieres reducir el blast radius de un worker incident.
Un VPS separado no es el primer arreglo. Primero resuelve queue semantics, retries, idempotency y monitoring. Un job mal diseñado seguirá estando mal diseñado en un segundo servidor.