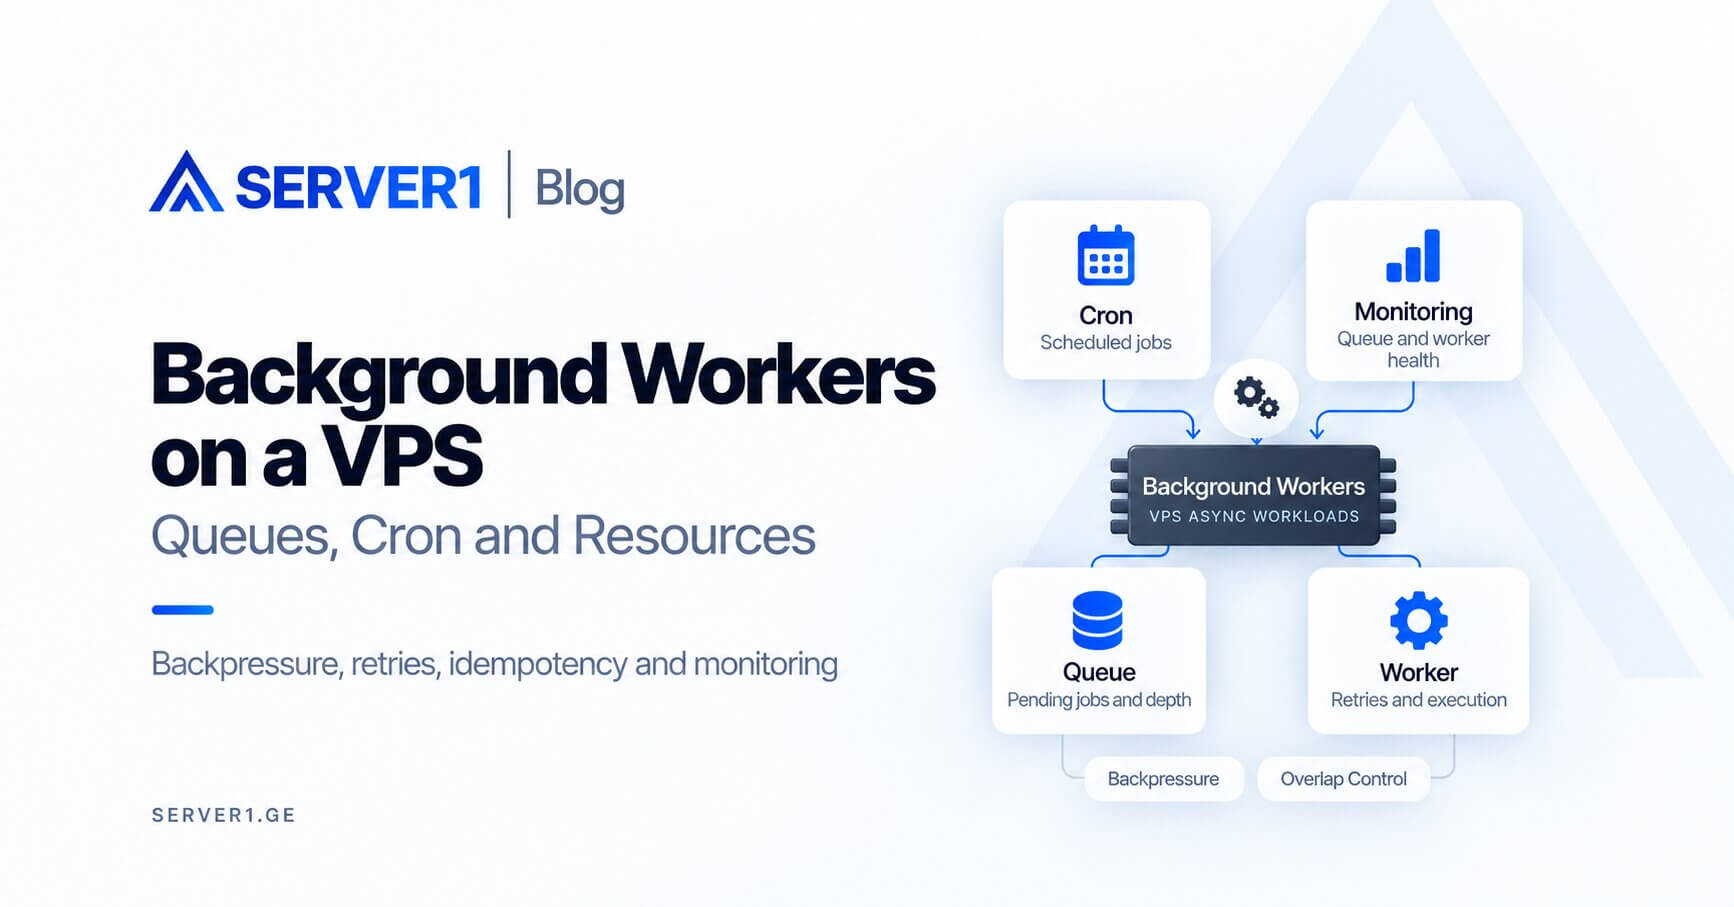
Background worker-ები და scheduled job-ები VPS-ზე ძალიან პრაქტიკულია, მაგრამ ისინი web request-ებისგან რესურსულად უნდა გააკონტროლოთ. ერთი ცუდი queue job, დიდი import ან overlap-ებული cron შეიძლება CPU, RAM ან database connections მთლიანად დაიკავოს და მომხმარებლის საიტი შეანელოს.
Web და Async ორი განსხვავებული workload-ია
| Web request | Background job |
|---|---|
| მომხმარებელი პასუხს ელოდება | შეიძლება რიგში დაელოდოს |
| latency კრიტიკულია | throughput ხშირად უფრო მნიშვნელოვანია |
| მოკლე execution სასურველია | შეიძლება წუთები გაგრძელდეს |
Worker-ს supervisor სჭირდება
Worker-ის ხელით SSH session-ში გაშვება production process management არ არის. გამოიყენეთ systemd, Supervisor ან შესაბამისი process manager, რათა crash-ის შემდეგ process დაბრუნდეს და logs პროგნოზირებადად შეინახოს.
Laravel-ის ჰოსტინგის პრაქტიკული სტატია queue worker-ისა და scheduler-ის კარგ მაგალითს იძლევა. სერვერის მართვის სტატია კი აჩვენებს, რატომ არის monitoring და ownership მუდმივი სამუშაო.
Cron-ის სამი პრობლემა, რომელიც ხშირად გვხვდება
- წინა job ჯერ არ დასრულებულა და ახალი უკვე იწყება;
- job-ს timeout ან resource limit არ აქვს;
- failure მხოლოდ log-ში რჩება და alert არ მოდის.
როგორ დავიცვათ user-facing workload
- worker concurrency გაზარდეთ მხოლოდ გაზომვის შემდეგ;
- დიდ import-ს off-peak window მიეცით;
- DB connection pool და limits აკონტროლეთ;
- queue depth და oldest-job age მონიტორინგში შეიტანეთ;
- retry-ისთვის idempotency გაითვალისწინეთ.
როდის გავიტანდი worker-ს ცალკე VPS-ზე?
როცა async workload დამოუკიდებლად იზრდება, CPU-heavy job-ები web latency-ს აზიანებს ან deployment/restart policy განსხვავდება. მანამდე ერთი VPS ხშირად სრულიად საკმარისია. თუ Linux ოპერაციებს თავად მართავთ, Unmanaged VPS მაქსიმალურ მოქნილობას გაძლევთ.
Queue-ს მიზანია მძიმე სამუშაო request path-იდან გაიტანოს. თუ იგივე worker შემდეგ მთელ VPS-ს ახრჩობს, bottleneck უბრალოდ სხვა პროცესში გადაიტანეთ.
თუ on-call და process supervision-ის ownership-ის შემცირება გინდათ, Managed VPS შეადარეთ. Application-level worker logic მაინც თქვენი კოდის პასუხისმგებლობად რჩება.
Backpressure: queue უსასრულო buffer არ არის
თუ producer წუთში 1,000 job-ს ქმნის და workers მხოლოდ 600-ს ამუშავებს, queue მუდმივად გაიზრდება. ამ დროს უბრალოდ worker count-ის ზრდა შეიძლება database/API-ს გადატვირთვით დასრულდეს. საჭირო ხდება backpressure: producer rate-ის შეზღუდვა, batch size-ის შემცირება ან დამატებითი capacity.
Retry strategy-ს გარეშე transient error შეიძლება incident-ად გადაიქცეს
| სცენარი | ცუდი რეაქცია | უკეთესი მიდგომა |
|---|---|---|
| API დროებით მიუწვდომელია | უსასრულო immediate retry | exponential backoff + retry limit |
| არავალიდური payload | ყოველ ჯერზე retry | fail/dead-letter + investigation |
| Payment-like operation | blind retry | idempotency key/state check |
| დიდი import | ერთი გიგანტური job | smaller resumable batches |
რა უნდა იყოს dashboard-ზე?
- queue depth;
- oldest pending job age;
- jobs processed per minute;
- failure/retry rate;
- worker CPU/RAM;
- database connection usage;
- external API latency, თუ job მასზეა დამოკიდებული.
Scheduled jobs-ზე overlap კონტროლი აუცილებელია
თუ ყოველ 5 წუთში გაშვებული task ზოგჯერ 8 წუთს მუშაობს, overlap გარდაუვალია, თუ lock ან single-run policy არ გაქვთ. იგივე ეხება backup, import და report generation-ს. Cron schedule ყოველთვის execution duration-თან ერთად უნდა განიხილოთ.
როდის გადავიტანოთ workers ცალკე VPS-ზე - უფრო ზუსტი კრიტერიუმები
- worker CPU peaks რეგულარულად ემთხვევა web latency-ის ზრდას;
- async workload-ის scaling web traffic-ისგან დამოუკიდებელია;
- worker deployment cadence განსხვავდება web application-ისგან;
- jobs-ს განსხვავებული security/network access სჭირდება;
- ერთი worker incident-ის blast radius-ის შემცირება გინდათ.
ცალკე VPS პირველი ნაბიჯი არ არის. ჯერ სწორად მოაწესრიგეთ queue semantics, retries, idempotency და monitoring. ცუდად დაწერილი job მეორე server-ზეც ცუდად იმუშავებს.