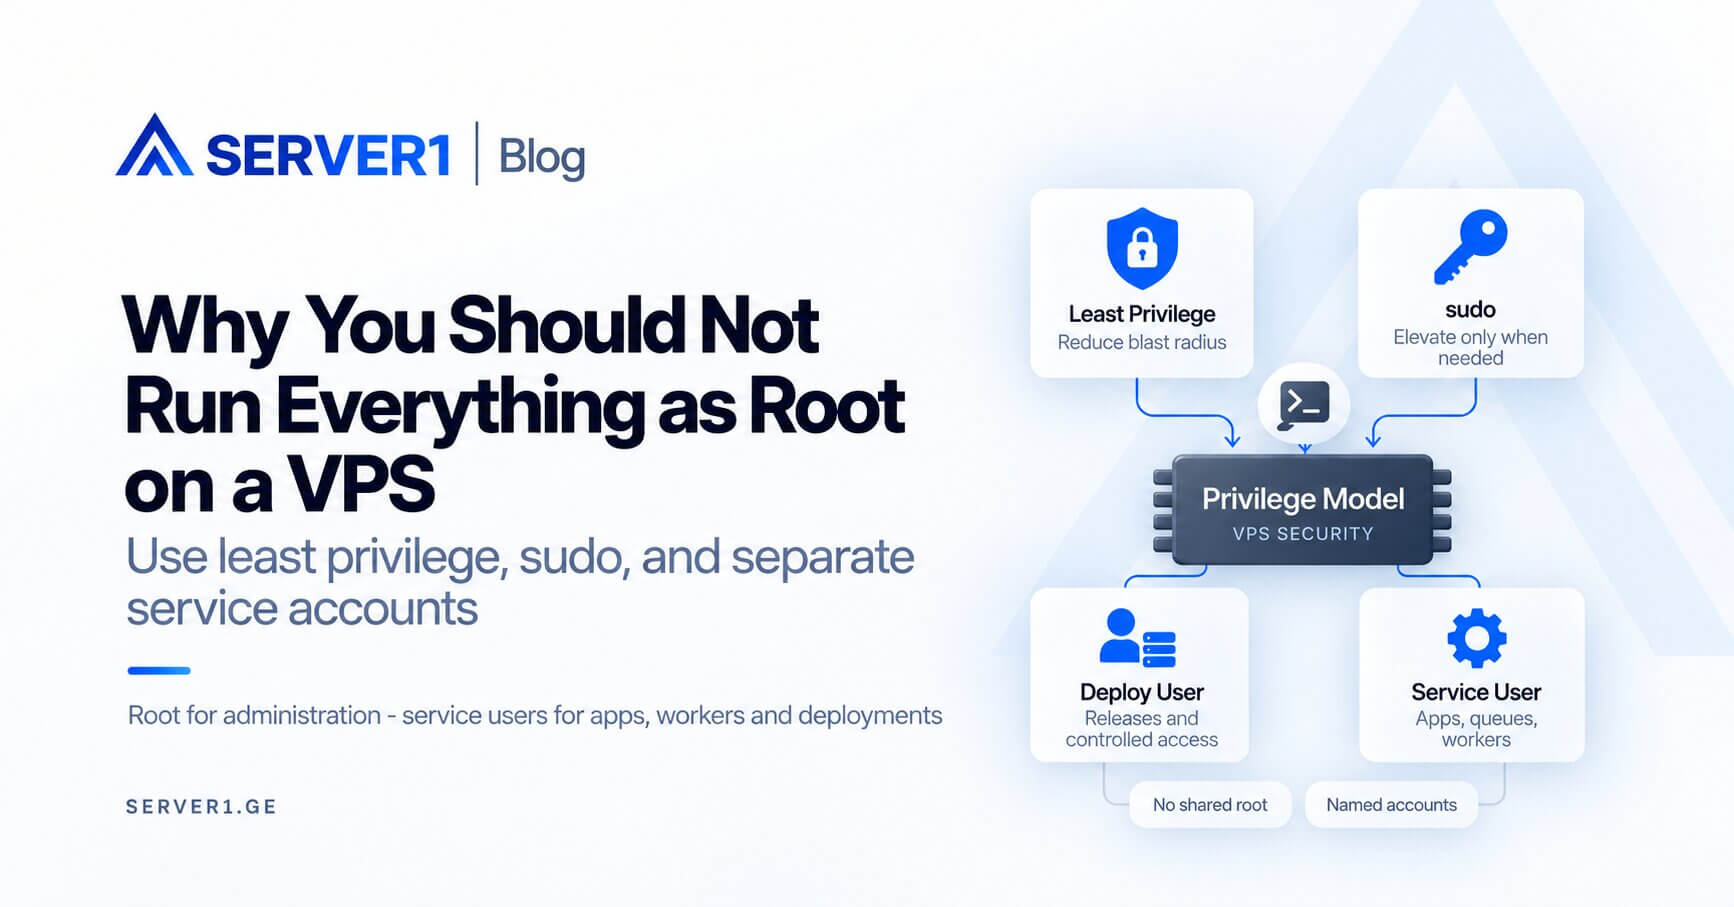
VPS-ზე root access აუცილებელია ადმინისტრირებისთვის, მაგრამ ყველაფრის root-ით გაშვება ცუდი პრაქტიკაა. თუ web application, worker, deployment script ან backup process root უფლებებით მუშაობს, ერთი bug ან ერთი კომპრომეტირებული process მთელ სისტემაზე ზედმეტად დიდ კონტროლს იღებს.
რეალური პრობლემა: ერთი შეცდომა, ძალიან დიდი ზიანი
წარმოიდგინეთ Node.js ან PHP process, რომელსაც შემთხვევით აქვს ფაილების წაშლის bug. ჩვეულებრივი service user-ის შემთხვევაში ზიანი იმ directories-ით შემოიფარგლება, რომლებზეც ამ user-ს წვდომა აქვს. root-ის შემთხვევაში ბუნებრივი საზღვარი თითქმის აღარ არსებობს.
სამი როლი, რომლებიც ერთმანეთისგან უნდა გაიმიჯნოს
| როლი | რისთვის გამოიყენება | რას უნდა მოერიდოთ |
|---|---|---|
| root | OS, packages, firewall, users | აპლიკაციის მუდმივი process |
| deploy user | release და controlled deploy | სისტემის სრული ადმინისტრირება |
| service user | PHP, Node, worker, queue | სხვა პროექტების ფაილებზე წვდომა |
ჰოსტინგის უსაფრთხოების ფენების მიმოხილვა კარგად აჩვენებს, რატომ არ არსებობს ერთი უნივერსალური დაცვის მექანიზმი. პრაქტიკული server-side კონტროლებისთვის სასარგებლოა სერვერის მართვის ინსტრუმენტების სტატია.
sudo-ს სწორი როლი
საუკეთესო პრაქტიკაა ადმინისტრატორი მუშაობდეს საკუთარი user-ით და მხოლოდ კონკრეტული ბრძანებისთვის გამოიყენოს sudo. გუნდში ყველას საკუთარი SSH key უნდა ჰქონდეს. საერთო root password განსაკუთრებით ცუდია, რადგან აღარ ჩანს ვინ რა შეცვალა.
Deployment-ის დროს
- კოდის owner იყოს deploy ან service user;
- secret files-ს ჰქონდეს მინიმალური permissions;
- web process-ს write access ჰქონდეს მხოლოდ საჭირო directories-ზე;
- system configuration root/admin ownership-ში დარჩეს.
root უნდა იყოს privilege, რომელსაც საჭიროებისას იყენებთ, და არა default identity, რომლითაც ყველაფერი მუშაობს.
თუ Linux administration თქვენს გუნდს ეკუთვნის, SERVER1 Unmanaged VPS გაძლევთ სრულ კონტროლს. თუ OS-level ოპერაციების გადაბარება გინდათ, შეადარეთ Managed VPS. პასუხისმგებლობების სწორად გაყოფის შესახებ დამატებით ნახეთ სერვერის მართვისა და დროის ეკონომიის სტატია.
როგორ გადავიდეთ „ყველაფერი root-ით“ მოდელიდან უსაფრთხო მოდელზე
არსებულ production server-ზე privilege model-ის შეცვლა ერთჯერადი მასობრივი `chown`-ით არ დაიწყოთ. ჯერ შეადგინეთ dependency map: რომელი process რომელი user-ით მუშაობს, სად წერს ფაილებს, რომელ socket-ს ან secret-ს კითხულობს და რომელი scheduled job შეიძლება root-ზე იყოს დამოკიდებული.
- Process inventory: ჩამოწერეთ root-ით გაშვებული long-running services და დაასაბუთეთ, მართლა სჭირდებათ თუ არა UID 0.
- File ownership: application code, uploads, cache და logs ერთმანეთისგან გამოყავით. ყველა directory writable არ უნდა იყოს.
- Privilege boundary: შექმენით კონკრეტული service accounts და sudo rules მხოლოდ რეალურად საჭირო ადმინისტრაციული ბრძანებებისთვის.
- Second-session test: SSH/sudo ცვლილებებისას ძველი session არ დახუროთ, სანამ ახალი access path არ გამოცადეთ.
- Observe before cleanup: deployment, cron და backup ერთი სრული ციკლი გაიაროს, სანამ ძველ უფლებებს საბოლოოდ წაშლით.
სწრაფი audit: სად შეიძლება root ზედმეტად გამოიყენებოდეს?
| რას ვამოწმებთ | რას ვეძებთ | სასურველი მდგომარეობა |
|---|---|---|
| Long-running processes | UID 0 process-ები | root მხოლოდ იქ, სადაც ტექნიკურად აუცილებელია |
| Application files | root-owned deploy tree | ცალკე deploy/service ownership |
| Scheduled jobs | ყველა cron root-ში | job-ისთვის მინიმალური საჭირო user |
| sudoers | ფართო `ALL=(ALL) ALL` წვდომა | პერსონალური account-ები და გააზრებული privilege |
| Secrets | ყველასთვის readable config | მინიმალური read permissions |
ეს ცვლილებები განსაკუთრებით ღირებულია მაშინ, როცა ერთ VPS-ზე რამდენიმე application ან კლიენტის პროექტი ცხოვრობს. ერთი პროექტის compromise არ უნდა გადაიქცეს მთელი VM-ის compromise-ად. სწორედ ამიტომ privilege separation უნდა განიხილოთ firewall-ის, updates-ის, backup-ის და monitoring-ის გვერდით და არა მათ ნაცვლად.
რას არ უნდა ველოდოთ least privilege-ისგან
ცალკე service user ვერ გამოასწორებს დაუპაჩავ vulnerability-ს, მოპარულ administrator key-ს ან ცუდად კონფიგურირებულ public database-ს. მისი მიზანია blast radius-ის შემცირება: როცა რაღაც მაინც გაფუჭდება, ზიანის საზღვარი უფრო ვიწრო იყოს.