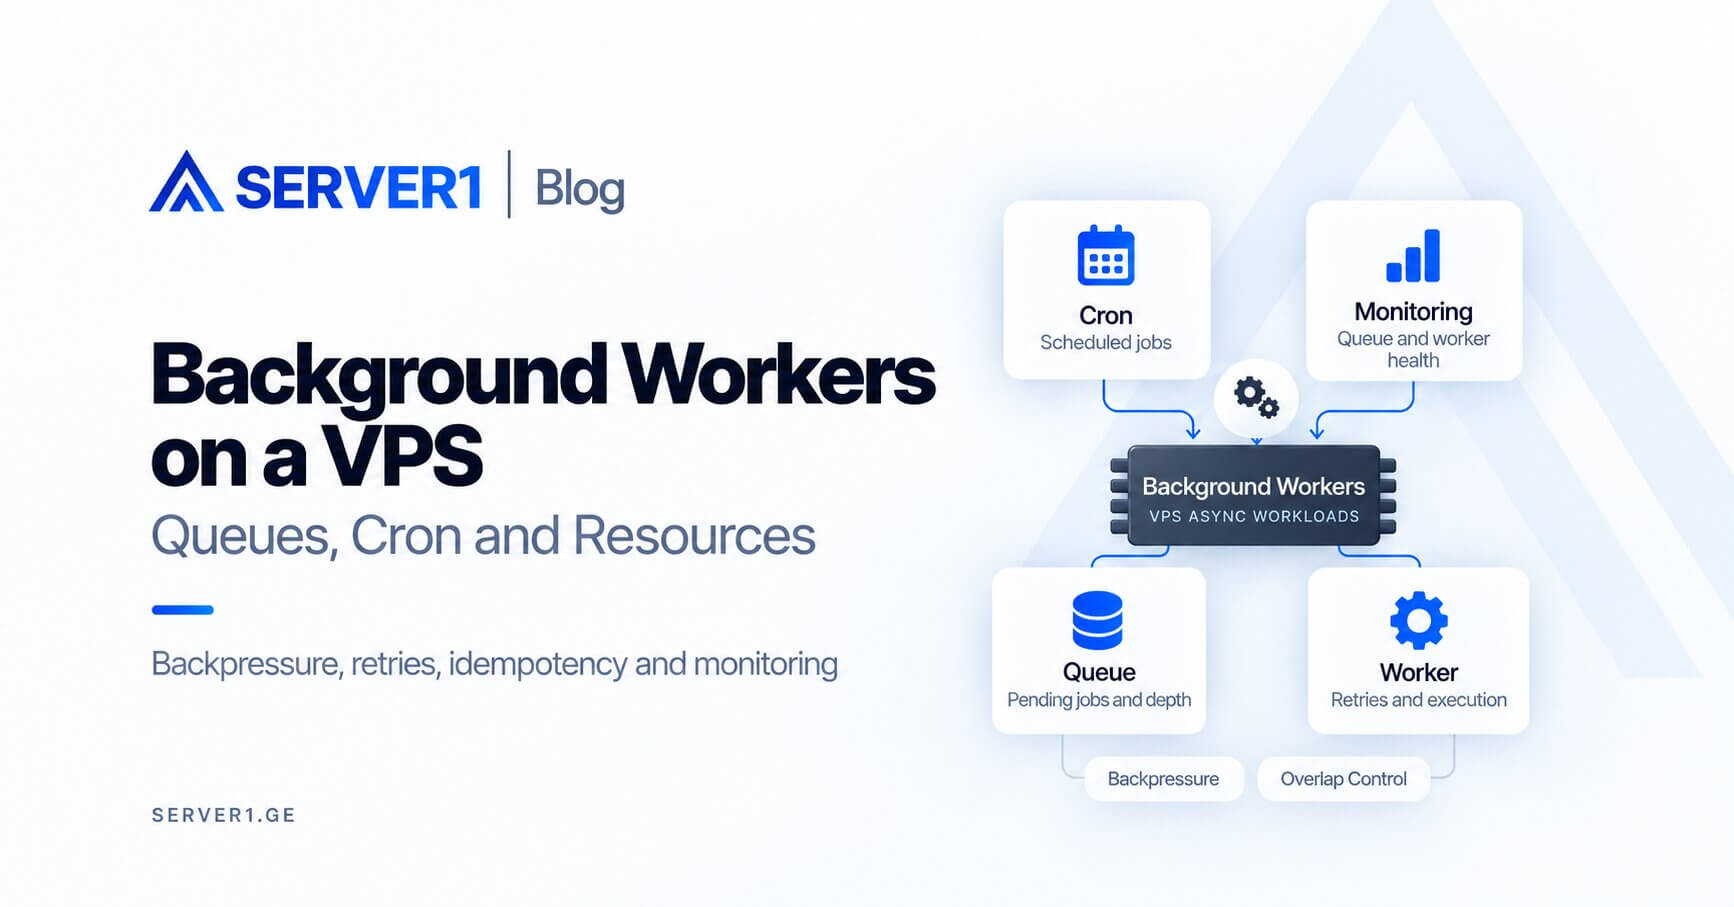
Background workers и scheduled jobs отлично подходят для VPS, но их ресурсы нужно отделять от user-facing web requests. Один тяжёлый queue job, большой import или перекрывающиеся cron-задачи способны занять CPU, RAM или database connections и замедлить основной сайт.
Web и Async - два разных типа нагрузки
| Web request | Background job |
|---|---|
| пользователь ждёт ответ | может подождать в queue |
| latency критична | throughput часто важнее |
| желательно короткое выполнение | может длиться минуты |
Worker нужен supervisor
Запускать worker вручную в SSH session - не production process management. Используйте systemd, Supervisor или подходящий process manager, чтобы процесс возвращался после crash и logs сохранялись предсказуемо.
гайд по Laravel hosting даёт хороший пример queue workers и scheduler. статья об управлении сервером показывает, почему monitoring и ownership - постоянная операционная работа.
Три типичных проблемы cron
- предыдущая задача ещё не завершилась, а следующая уже стартует;
- у job нет timeout или разумного resource limit;
- ошибка попадает в log, но не создаёт alert.
Как защитить user-facing workload
- увеличивайте worker concurrency только после измерений;
- большие imports запускайте вне peak;
- контролируйте DB connection pools и limits;
- мониторьте queue depth и oldest-job age;
- учитывайте idempotency для безопасных retries.
Когда выносить workers на отдельный VPS?
Когда async workload растёт независимо, CPU-heavy jobs ухудшают web latency или deployment/restart policy начинает отличаться. До этого одного VPS часто достаточно. Если Linux operations остаются у вашей команды, Unmanaged VPS даёт максимальную гибкость.
Queue должна убирать тяжёлую работу из request path, а не просто переносить bottleneck в другой процесс на том же сервере.
Если хотите сократить нагрузку на on-call и process supervision, сравните с Managed VPS. Логика application-level workers всё равно остаётся частью вашего кода.
Backpressure: queue не является бесконечным buffer
Если producers создают 1,000 jobs в минуту, а workers обрабатывают только 600, queue будет постоянно расти. Простое увеличение workers может перегрузить database или внешний API. Нужен backpressure: ограничение producer rate, меньшие batches или осознанное увеличение capacity.
Без retry strategy временная ошибка может превратиться в incident
| Сценарий | Плохая реакция | Лучший подход |
|---|---|---|
| API временно недоступен | бесконечный immediate retry | exponential backoff + retry limit |
| невалидный payload | retry навсегда | fail/dead-letter + investigation |
| payment-like operation | blind retry | idempotency key/state check |
| большой import | один огромный job | небольшие resumable batches |
Что должно быть на dashboard?
- queue depth;
- возраст самого старого pending job;
- jobs processed per minute;
- failure/retry rate;
- worker CPU/RAM;
- database connection usage;
- external API latency, если jobs от него зависят.
Scheduled jobs требуют overlap control
Если задача запускается каждые пять минут, но иногда работает восемь, executions начнут пересекаться без lock или single-run policy. То же относится к backups, imports и report generation.
Когда workers действительно стоит вынести на другой VPS
- worker CPU peaks регулярно совпадают с ростом web latency;
- async demand масштабируется независимо от web traffic;
- worker deployment cadence отличается от web application;
- jobs нужен другой security/network access;
- нужно уменьшить blast radius worker incident.
Отдельный VPS - не первый фикс. Сначала правильно настройте queue semantics, retries, idempotency и monitoring. Плохо спроектированный job останется плохим и на втором сервере.