ენა

GPU სერვერის ძებნა ხშირად მოდელის სახელით იწყება და ბარათის სახელით გრძელდება. ამ ორ სახელს შორის კი მთავარი სამუშაო რჩება: რას აკეთებს მოდელი, რამდენ ადამიანს უნდა უპასუხოს და რა მეხსიერებას მოიხმარს ამ პირობებში? სანამ კონფიგურაციას შეუკვეთავთ, სასარგებლოა მოთხოვნა პატარა ექსპერიმენტად ჩამოაყალიბოთ.
ჯერ დაარქვით სამუშაოს სწორი სახელი
Inference არის უკვე მომზადებული მოდელის გამოყენება პასუხის ან სხვა შედეგის მისაღებად. Fine-tuning მოდელს დამატებითი მონაცემებით ამუშავებს; მისი მეთოდი და განახლებადი პარამეტრები მეხსიერების მოთხოვნას ცვლის. Full training უფრო ფართო სასწავლო პროცესია და inference-ის რესურსის შეფასებას პირდაპირ ვერ დაეყრდნობა.
მოამზადეთ კონკრეტული ამოცანა: ტექსტის გენერაცია, embeddings, სურათის დამუშავება ან სხვა pipeline. ერთი და იგივე მოდელის ოჯახშიც ვერსია, framework და ამოცანის რეჟიმი განსხვავებას ქმნის. მხოლოდ პარამეტრების რაოდენობის ჩაწერა საკმარისი არ არის.
სიტყვა „AI“ workload-ის ნაცვლად ვერ გამოდგება. იმავე მოდელის ერთჯერადი დამუშავება, მუდმივი API მომსახურება და სასწავლო ციკლი სხვადასხვა მიღების პირობას მოითხოვს. მოთხოვნაში ჯერ აღწერეთ შედეგი: მაგალითად, რამდენი პასუხი უნდა დაბრუნდეს შეთანხმებულ დროში, ან რა მოცულობის მონაცემზე უნდა დასრულდეს საცდელი ადაპტაცია. რიცხვები თქვენი მიზნიდან უნდა მოდიოდეს და გაზომვით დადასტურდეს.
VRAM-ის ჩანაწერი მხოლოდ მოდელის წონები არ არის
საწყისი არითმეტიკაა პარამეტრების რაოდენობა x ბაიტები თითო პარამეტრზე. მაგალითად, ჰიპოთეზური 8 მილიარდი პარამეტრის წონები 2 ბაიტით დაახლოებით 16 GB-ს, ანუ დაახლოებით 14.90 GiB-ს იკავებს. ეს მხოლოდ წონების თეორიული მოცულობაა.
4-bit წარმოდგენით მარტივი ქვედა შეფასება 4 GB გამოდის, მაგრამ quantization metadata, runtime buffers და სხვა კომპონენტები დამატებით ადგილს მოითხოვს. ამიტომ „4 GB წონები“ არ ნიშნავს „მოდელი 4 GB GPU-ზე იმუშავებს“. ფორმატი და მეთოდი კონკრეტულ მოდელთან უნდა შემოწმდეს.
Weights-ის თეორიული გამოთვლა საწყისი ფილტრია. თუ მხოლოდ წონები ეტევა ბარათში თითქმის ბოლომდე, დანარჩენ სამუშაოს სივრცე აღარ რჩება. ამავე დროს, runtime-ის მიხედვით ზოგი განაწილება შეიძლება განსხვავდებოდეს. ამიტომ მოდელის პარამეტრების რაოდენობიდან მთლიანი VRAM მოთხოვნის ერთი ზუსტი რიცხვით გამოცხადება უსაფუძვლო სიზუსტეა.
მეხსიერების გამოთვლაში გაარჩიეთ ათობითი GB და ორობითი GiB. ეს აღნიშვნები სხვადასხვა რაოდენობას აღწერს. თუ გამყიდველის სპეციფიკაციასა და ხელსაწყოს მონიტორინგში განსხვავებული რიცხვი გამოჩნდა, ჯერ ერთეული შეადარეთ. ერთეულების შეუსაბამობა ავტომატურად არც დანაკარგს ამტკიცებს და არც აპარატურის გაუმართაობას.
Context და ერთდროული მომხმარებლები
ავტორეგრესიული მოდელების inference-ში KV cache კონტექსტის ინფორმაციას ინახავს და მისი მოცულობა სამუშაო პირობებზეა დამოკიდებული. შემავალი ტექსტი, გენერირებული გაგრძელება და ერთდროული sequence-ები საერთო მოთხოვნას ზრდის. ორი დემოს ერთი მოკლე prompt-ით შედარება Production რეჟიმს ვერ აფასებს.
Batch throughput-ის ზრდაში შეიძლება დაგეხმაროთ, თუმცა მომხმარებლის latency-სა და პიკურ მეხსიერებასაც შეამოწმეთ. Cache-ის quantization ან CPU offload VRAM-ის მოთხოვნას ცვლის, მაგრამ შედეგს აქვს წარმადობისა და თავსებადობის კომპრომისები. მცირე მეხსიერების მოხმარება ავტომატურად საუკეთესო პასუხის დროს არ ნიშნავს.
Context window-ის მაქსიმალური მხარდაჭერა და თქვენი სერვისის ჩვეულებრივი მოთხოვნა სხვადასხვა რამეა. ფასის შედარებისთვის ჩაიწეროს ტიპური input, მოსალოდნელი output და მათი ყველაზე მნიშვნელოვანი გრძელი შემთხვევები. მხოლოდ მოკლე prompt-ით წარმატებული ცდა გრძელი დოკუმენტების დამუშავებას ვერ დაადასტურებს.
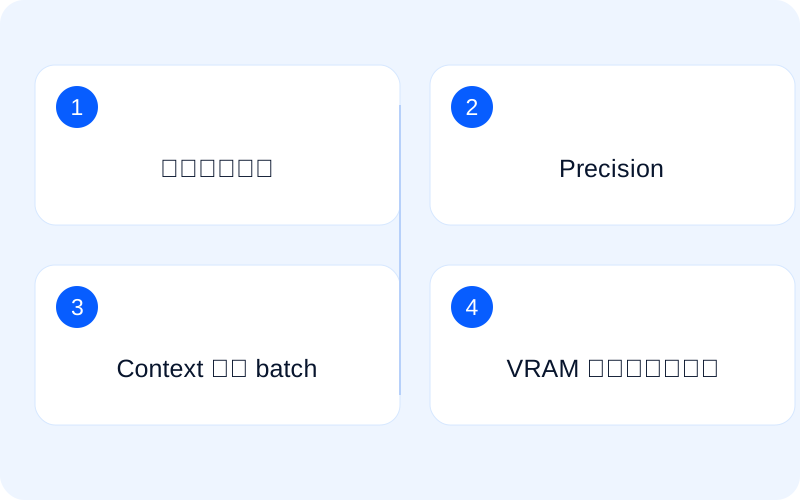
ერთსა და იმავე მოდელს ორი განსხვავებული სერვერი შეიძლება სჭირდებოდეს
სცენარი A: მოდელი პასუხებს აბრუნებს
პირველ, პირობით სცენარში გუნდი უკვე შერჩეულ მოდელს API-ით ამუშავებს. აქ სასარგებლოა პასუხამდე პირველი დაყოვნების, გენერაციის მიმდინარეობისა და რამდენიმე მომხმარებლის ერთდროული მოთხოვნის დანახვა. მეტი concurrent სესია ზოგ შემთხვევაში throughput-ს ზრდის, მაგრამ ცალკეული მომხმარებლის პასუხს აყოვნებს. მისაღები ბალანსი სამუშაო მოთხოვნაში უნდა ჩაიწეროს.
სცენარი B: მოდელს ვარგებთ საკუთარ ამოცანას
მეორე სცენარში გუნდს მოდელის ადაპტაცია სურს. აქ inference-ის წარმატებული გაშვება საკმარისი დასტური აღარ არის: იცვლება სასწავლო რეჟიმი, batch, precision და სხვა სამუშაო კომპონენტები. LoRA/QLoRA და full fine-tuning ერთ ფასის შედარებაში ერთნაირ მოთხოვნად არ მოაქციოთ. მეთოდი, framework და მოდელის მხარდაჭერა წინასწარ უნდა დადასტურდეს.
როგორ წავიკითხოთ საცდელი გაშვება
საცდელ გარემოში გამოიყენეთ რეალური ამოცანის მსგავსი, უფლებამოსილი და საჭიროებისას გაუპიროვნებული მონაცემები. შეამოწმეთ მოკლე და გრძელი input, ერთეული და პარალელური მოთხოვნები. შეინახეთ მოდელის, driver-ისა და framework-ის ვერსიები, peak memory, შეცდომები და პასუხის დრო.
Fine-tuning-ს inference-ის შედეგიდან ნუ დაგეგმავთ: optimizer state, gradients, activations და მეთოდის სხვა კომპონენტები ბიუჯეტს ცვლის. CPU, სისტემური RAM, storage და მონაცემთა მიწოდება ასევე შეიძლება შემზღუდველი აღმოჩნდეს. GPU მარტო მთელი სისტემის წარმადობას არ განსაზღვრავს.
ცდაში ჩაიწეროს მოდელის ზუსტი ვერსია, runtime, precision და გაშვების პარამეტრები. ეს ჩანაწერი საშუალებას გაძლევთ, შედეგი მოგვიანებით გაიმეოროთ. warm-up და პირველი გაშვება ცალკე მონიშნეთ; მოდელის ჩამოტვირთვა ან საწყისი ინიციალიზაცია ჩვეულებრივი მოთხოვნის დროს არ აურიოთ. საცდელი მონაცემი წარმომადგენლობითი უნდა იყოს და მისი გამოყენების უფლებაც უნდა გქონდეთ.
თუ ცდა მეხსიერების შეცდომით დასრულდა, ერთდროულად ყველა პარამეტრი ნუ შეცვლით. შეინახეთ შედეგი, შეცვალეთ ერთი დასაბუთებული ფაქტორი და გაიმეორეთ იგივე სამუშაო. შერჩეული ბარათის შეფასებისთვის მნიშვნელოვანია როგორც წარმატებული გაშვება, ისე საზღვარი, რომელთანაც ის ვეღარ ასრულებს თქვენს მისაღებ პირობას.
კონფიგურაციის გარდა მოსამზადებელია გარემოც
რამდენიმე GPU-ის VRAM ავტომატურად ერთი უწყვეტი მეხსიერება არ ხდება. მოდელის განაწილება framework-ის მხარდაჭერასა და hardware topology-ზეა დამოკიდებული. გადაამოწმეთ მხარდაჭერილი software stack, საჭირო მართვის მოცულობა, ვადა და ხელმისაწვდომობა.
რამდენიმე GPU-ზე განაწილება ცალკე ტექნიკური გადაწყვეტილებაა. VRAM-ის ნომინალური ჯამი არ ნიშნავს, რომ ნებისმიერი მოდელი ამ მთლიან სივრცეს ერთ ბარათად დაინახავს. გადაამოწმეთ გამოყენებული პროგრამული სტეკის მხარდაჭერა, კავშირი და workload-ის გაყოფის გზა. ასეთ სისტემაზე დაპირებული შედეგი წარმომადგენლობითი ცდით უნდა დადასტურდეს.
მოდელისა და მონაცემის გამოყენების პირობები კონფიგურაციის არჩევამდე განიხილეთ. ასევე გადაამოწმეთ driver/runtime-ის თავსებადობა, საცავის საჭიროება და ადმინისტრირების scope. თუ პროექტს აქვს განთავსების ან ხელმისაწვდომობის განსაკუთრებული მოთხოვნა, ის წინასწარ მიაწოდეთ მომწოდებელს. ჩვეულებრივი GPU შეთავაზებიდან სპეციალური შესაბამისობის ან იზოლაციის გარანტია არ გამომდინარეობს.
მოთხოვნა, რომელსაც შეთავაზების შედარება მოჰყვება
Brief-ში გამოყავით აუცილებელი მოთხოვნა და სასურველი ვარიანტი. მაგალითად, მკაცრი latency შეიძლება უფრო მნიშვნელოვანი იყოს, ვიდრე მაქსიმალური batch throughput. ეს საშუალებას იძლევა შეთავაზებები ერთი და იმავე სამუშაო რეჟიმით შეადაროთ.
| საკითხი | რა მიუთითოთ |
|---|---|
| მოდელი | ზუსტი სახელწოდება, ვერსია და გამოყენების უფლება |
| სამუშაო | Inference, fine-tuning ან სხვა რეჟიმი |
| წარმოდგენა | Precision/quantization და framework |
| მოთხოვნა | Context, output, batch და concurrency |
| მიზანი | მისაღები latency, throughput და ხარისხი |
| ოპერირება | მონაცემები, storage, RAM, მართვა და backup |
GPU სერვერის მიმდინარე ვარიანტების შესადარებლად გააგზავნეთ მოდელის ვერსია, სამუშაო რეჟიმი და საცდელი შედეგი. თუ ტესტი ჯერ არ გაქვთ, ეს პირდაპირ მიუთითეთ. ასე საუბარი ბარათის სახელიდან გადადის იმ სამუშაოზე, რომლის შესრულებაც რეალურად გჭირდებათ.
თუ შეკითხვა ზოგადი სერვერის რესურსებსაც ეხება: Linux VPS Monitoring: CPU, RAM, Disk და Load როგორ წავიკითხოთ სწორად.
მეხსიერების, cache-ისა და adapter training-ის დეტალები: Hugging Face - GPU memory usage; Hugging Face - Cache strategies.