Idioma

La búsqueda de un servidor GPU suele empezar por el nombre del modelo y saltar al de la tarjeta. Entre ambos queda lo esencial: qué hará el modelo, a cuántas personas atenderá y cuánta memoria usará en esas condiciones. Antes de pedir hardware, convierta el requisito en un pequeño experimento.
Dé a la carga su nombre correcto
La inferencia utiliza un modelo preparado para producir una respuesta u otro resultado. Fine-tuning lo adapta con datos adicionales; método y parámetros entrenables cambian la memoria. El entrenamiento completo es un proceso más amplio y no puede dimensionarse directamente desde una estimación de inferencia.
Defina la tarea: generación de texto, embeddings, imágenes u otro pipeline. Dentro de una familia pueden variar versiones, frameworks y modos. El número de parámetros no constituye un requisito completo.
AI no sustituye la descripción de la carga. Un lote puntual, una API permanente y un ciclo de entrenamiento necesitan aceptaciones distintas. Describa primero el resultado: cuántas respuestas llegarán en un plazo o qué conjunto de datos completará una adaptación piloto. Derive las cifras del objetivo y compruébelas midiendo.
La VRAM incluye más que los pesos
Un cálculo inicial multiplica parámetros por bytes por parámetro. Por ejemplo, ocho mil millones de parámetros hipotéticos a dos bytes ocupan unos 16 GB, aproximadamente 14.90 GiB. Es solo el almacenamiento teórico de pesos.
A cuatro bits, la estimación inferior simple es 4 GB, pero metadatos de cuantización, buffers y otros componentes requieren espacio. Cuatro gigabytes de pesos no demuestran que la aplicación funcione en una GPU de 4 GB. Compruebe formato y método para el modelo concreto.
El cálculo teórico de pesos es un filtro inicial. Si casi llenan la tarjeta, queda poco espacio para lo demás. El runtime también puede modificar las asignaciones. Deducir una cifra exacta de VRAM total solo del número de parámetros introduce una precisión sin fundamento.
Distinga GB decimales y GiB binarios: representan cantidades diferentes. Si la ficha del proveedor y la monitorización muestran números distintos, compare primero las unidades. Esa diferencia no demuestra por sí sola capacidad perdida ni hardware defectuoso.
Contexto y usuarios simultáneos
En inferencia autorregresiva, la caché KV conserva contexto y su tamaño depende del trabajo. Texto de entrada, continuación generada y secuencias simultáneas afectan la demanda. Comparar demos con un prompt corto no caracteriza producción.
El procesamiento por lotes puede mejorar throughput, pero revise latencia y memoria máxima. Cuantizar caché o descargarla a CPU cambia VRAM con compromisos de rendimiento y compatibilidad. Menor consumo no significa automáticamente mejor respuesta.
La ventana de contexto máxima admitida difiere de una petición habitual. Para comparar costes, registre entrada típica, salida prevista y casos largos importantes. Superar una prueba con un prompt corto no valida documentos extensos.
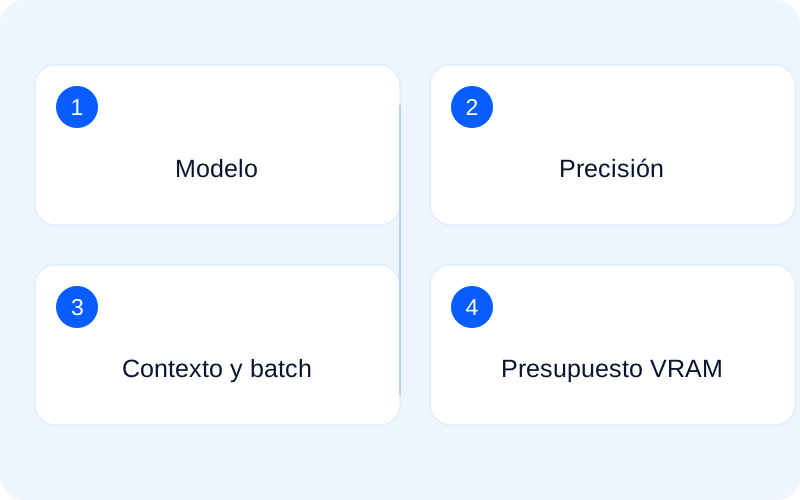
Un modelo puede conducir a dos servidores distintos
Escenario A: el modelo sirve respuestas
En el primer escenario hipotético, un equipo sirve un modelo ya elegido mediante API. Observe tiempo hasta la primera respuesta, generación sostenida y varios usuarios simultáneos. Más sesiones pueden elevar throughput y ralentizar una respuesta individual. El requisito debe expresar el equilibrio admisible.
Escenario B: el modelo se adapta a una tarea
En el segundo escenario, el equipo adapta el modelo. Superar inferencia ya no prueba preparación: cambian método de entrenamiento, batch, precisión y componentes de trabajo. No trate LoRA/QLoRA y fine-tuning completo como requisitos equivalentes al comparar precios. Confirme antes método, framework y soporte del modelo.
Interprete el piloto con cuidado
En una prueba acordada, utilice datos autorizados parecidos a la tarea real y anonimizados cuando corresponda. Compruebe entradas cortas y largas, peticiones individuales y paralelas. Registre versiones de modelo, driver y framework, memoria máxima, errores y respuesta.
No dimensione fine-tuning a partir de inferencia. Estados del optimizador, gradientes, activaciones y componentes del método cambian el presupuesto. CPU, RAM, almacenamiento y suministro de datos también pueden limitar el sistema. La GPU no determina todo el rendimiento.
Registre revisión exacta del modelo, runtime, precisión y parámetros de inicio. Así podrá reproducir el resultado. Separe calentamiento y primer arranque; descargar pesos o inicializar el proceso no equivale a una petición normal. Utilice datos representativos cuyo procesamiento tenga autorizado.
Ante un error de memoria, no cambie todos los parámetros. Conserve el resultado, ajuste un factor justificado y repita la misma carga. Evalúe tanto el funcionamiento correcto como la frontera a partir de la cual deja de cumplirse la aceptación.
Prepare el entorno además del hardware
La memoria de varias GPU no se convierte automáticamente en un espacio continuo. Distribuir el modelo depende del framework y la topología del hardware. Confirme stack compatible, alcance de gestión, plazo y disponibilidad.
Distribuir trabajo entre varias GPU es una decisión técnica aparte. Sumar VRAM nominal no significa que cualquier modelo la vea como una sola tarjeta. Confirme soporte del software, interconexión y reparto de trabajo. Un piloto representativo debe respaldar la expectativa de rendimiento.
Revise las condiciones de uso del modelo y los datos antes de elegir la configuración. Confirme compatibilidad driver/runtime, almacenamiento y alcance de administración. Comunique requisitos especiales de ubicación o acceso. Una oferta GPU estándar no establece garantías especializadas de aislamiento o cumplimiento.
Una solicitud que permita comparar
Separe requisitos obligatorios y preferencias. Una latencia estricta puede ser más importante que el máximo throughput por lote. Así compara ofertas bajo el mismo modo, no solo por el nombre de una GPU.
| Área | Qué aportar |
|---|---|
| Modelo | Nombre exacto, versión y derechos de uso |
| Tarea | Inferencia, fine-tuning u otro modo |
| Representación | Precisión/cuantización y framework |
| Demanda | Contexto, salida, batch y concurrencia |
| Objetivo | Latencia, throughput y calidad aceptables |
| Operación | Datos, storage, RAM, gestión y backup |
Para comparar servidores GPU vigentes, envíe revisión del modelo, modo de trabajo y resultado piloto. Si aún no existe una prueba, indíquelo. La conversación podrá centrarse en el trabajo necesario, además del nombre de la tarjeta.
Para observar recursos generales del servidor: Monitoring de Linux VPS: cómo interpretar CPU, RAM, Disk y Load.
Detalles de memoria, caché y entrenamiento con adaptadores: Hugging Face - GPU memory usage; Hugging Face - Cache strategies.