Язык

Поиск GPU-сервера часто начинается с названия модели и сразу переходит к названию карты. Между ними остается главное: что делает модель, скольким людям отвечает и сколько памяти использует в этих условиях? До заказа оборудования полезно превратить требование в небольшой эксперимент.
Дайте нагрузке точное название
Inference использует подготовленную модель для получения ответа или другого результата. Fine-tuning адаптирует ее дополнительными данными; метод и обучаемые параметры меняют потребление памяти. Full training является более широким обучением и не рассчитывается напрямую по inference.
Укажите задачу: генерация текста, embeddings, обработка изображений или другой pipeline. Даже внутри семейства моделей версии, frameworks и режимы различаются. Одного числа параметров недостаточно.
AI не заменяет описание нагрузки. Разовый batch, постоянный API и цикл обучения имеют разные критерии приемки. Сначала опишите результат: сколько ответов должно поступить за согласованное время или на каком наборе данных должна завершиться пробная адаптация. Цифры выводятся из цели и подтверждаются измерением.
VRAM включает не только веса
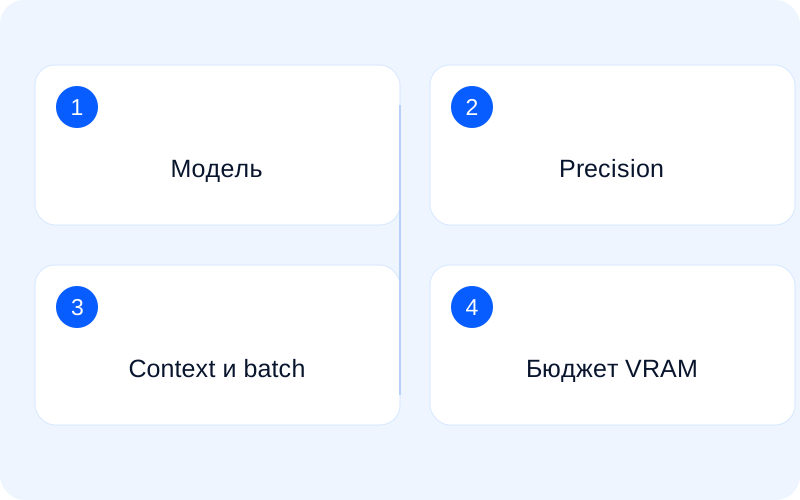
Начальная арифметика: число параметров умножить на байты на параметр. Условные восемь миллиардов параметров по два байта дают около 16 GB, примерно 14.90 GiB. Это только теоретический объем хранения весов.
Для четырех бит простая нижняя оценка равна 4 GB, но metadata quantization, runtime buffers и прочие компоненты требуют дополнительного места. Четыре гигабайта весов не доказывают работу приложения на GPU с 4 GB. Формат и метод проверяйте для конкретной модели.
Теоретический расчет весов является первым фильтром. Если веса почти заполняют карту, остальным компонентам остается мало места. Runtime также влияет на распределение. Одно точное значение всей VRAM, выведенное только из числа параметров, создает неподтвержденную точность.
Различайте десятичные GB и двоичные GiB. Это разные количества. Если спецификация поставщика и мониторинг показывают разные числа, сначала сравните единицы. Их несовпадение само по себе не доказывает потерю емкости или неисправность.
Context и одновременные пользователи
При авторегрессивном inference KV cache хранит контекстную информацию и зависит от условий workload. Входной текст, генерируемое продолжение и одновременные последовательности влияют на объем. Один короткий prompt в демо не характеризует Production.
Batch может повысить throughput, но проверьте latency пользователя и пиковую память. Quantization кеша или CPU offload меняют VRAM с компромиссами по скорости и совместимости. Минимальная память не означает автоматически лучшее время ответа.
Максимальный context window отличается от обычного запроса сервиса. Для сравнения цены запишите типичный input, ожидаемый output и важные длинные случаи. Успех с коротким prompt не подтверждает обработку длинных документов.
Одна модель может привести к двум разным серверам
Сценарий A: модель возвращает ответы
В первом условном сценарии команда обслуживает выбранную модель через API. Наблюдайте время до первого ответа, ход генерации и несколько одновременных пользователей. Рост concurrent sessions может повышать throughput и одновременно замедлять отдельный ответ. Допустимый баланс должен попасть в требование.
Сценарий B: модель адаптируется к задаче
Во втором сценарии команда адаптирует модель. Успешного inference уже недостаточно: меняются режим обучения, batch, precision и рабочие компоненты. Не приравнивайте LoRA/QLoRA к full fine-tuning при сравнении цены. Заранее подтвердите метод, framework и поддержку модели.
Читайте результат пилота внимательно
В согласованной среде используйте разрешенные данные, похожие на реальные, при необходимости обезличенные. Проверьте короткий и длинный input, одиночные и параллельные запросы. Сохраните версии модели, driver/framework, peak memory, ошибки и время ответа.
Не оценивайте fine-tuning по результату inference. Optimizer state, gradients, activations и особенности метода меняют бюджет. CPU, системная RAM, storage и доставка данных также могут ограничивать систему. GPU не определяет ее производительность в одиночку.
Запишите точную revision модели, runtime, precision и параметры запуска. Это позволяет повторить результат. Отдельно отметьте warm-up и первый старт; скачивание весов и инициализация процесса не являются обычным запросом. Используйте представительные данные, которые имеете право обрабатывать.
При ошибке памяти не меняйте сразу все параметры. Сохраните результат, измените один обоснованный фактор и повторите ту же работу. Важно оценить как успешный запуск, так и границу, после которой система не выполняет условие приемки.
Подготовьте окружение вместе с оборудованием
VRAM нескольких GPU автоматически не превращается в один непрерывный объем. Распределение модели зависит от framework и hardware topology. Уточните поддерживаемый stack, управление, срок и наличие.
Распределение по нескольким GPU является отдельным инженерным решением. Сумма номинальной VRAM не означает, что любая модель увидит ее одной картой. Подтвердите поддержку стека, соединение и разделение работы. Ожидаемый результат должен опираться на представительный пилот.
Рассмотрите условия использования модели и данных до выбора конфигурации. Уточните совместимость driver/runtime, хранение и scope администрирования. Особые требования к размещению и доступу сообщите заранее. Стандартное GPU-предложение не устанавливает специальных гарантий изоляции или соответствия.
Запрос для содержательного сравнения
Разделите обязательные требования и пожелания. Например, строгая latency может быть важнее максимального batch throughput. Тогда предложения сравниваются в одинаковом режиме, а не по названию оборудования.
| Область | Что сообщить |
|---|---|
| Модель | Название, версия и права использования |
| Задача | Inference, fine-tuning или иной режим |
| Представление | Precision/quantization и framework |
| Нагрузка | Context, output, batch и concurrency |
| Цель | Допустимые latency, throughput и качество |
| Эксплуатация | Данные, storage, RAM, управление и backup |
Для сравнения актуальных GPU-серверов отправьте revision модели, режим работы и результат пилота. Если теста еще нет, сообщите об этом прямо. Тогда разговор перейдет от названия карты к нужной работе.
Для наблюдения за общими ресурсами сервера: Monitoring Linux VPS: как правильно читать CPU, RAM, Disk и Load.
Подробности памяти, cache и adapter training: Hugging Face - GPU memory usage; Hugging Face - Cache strategies.