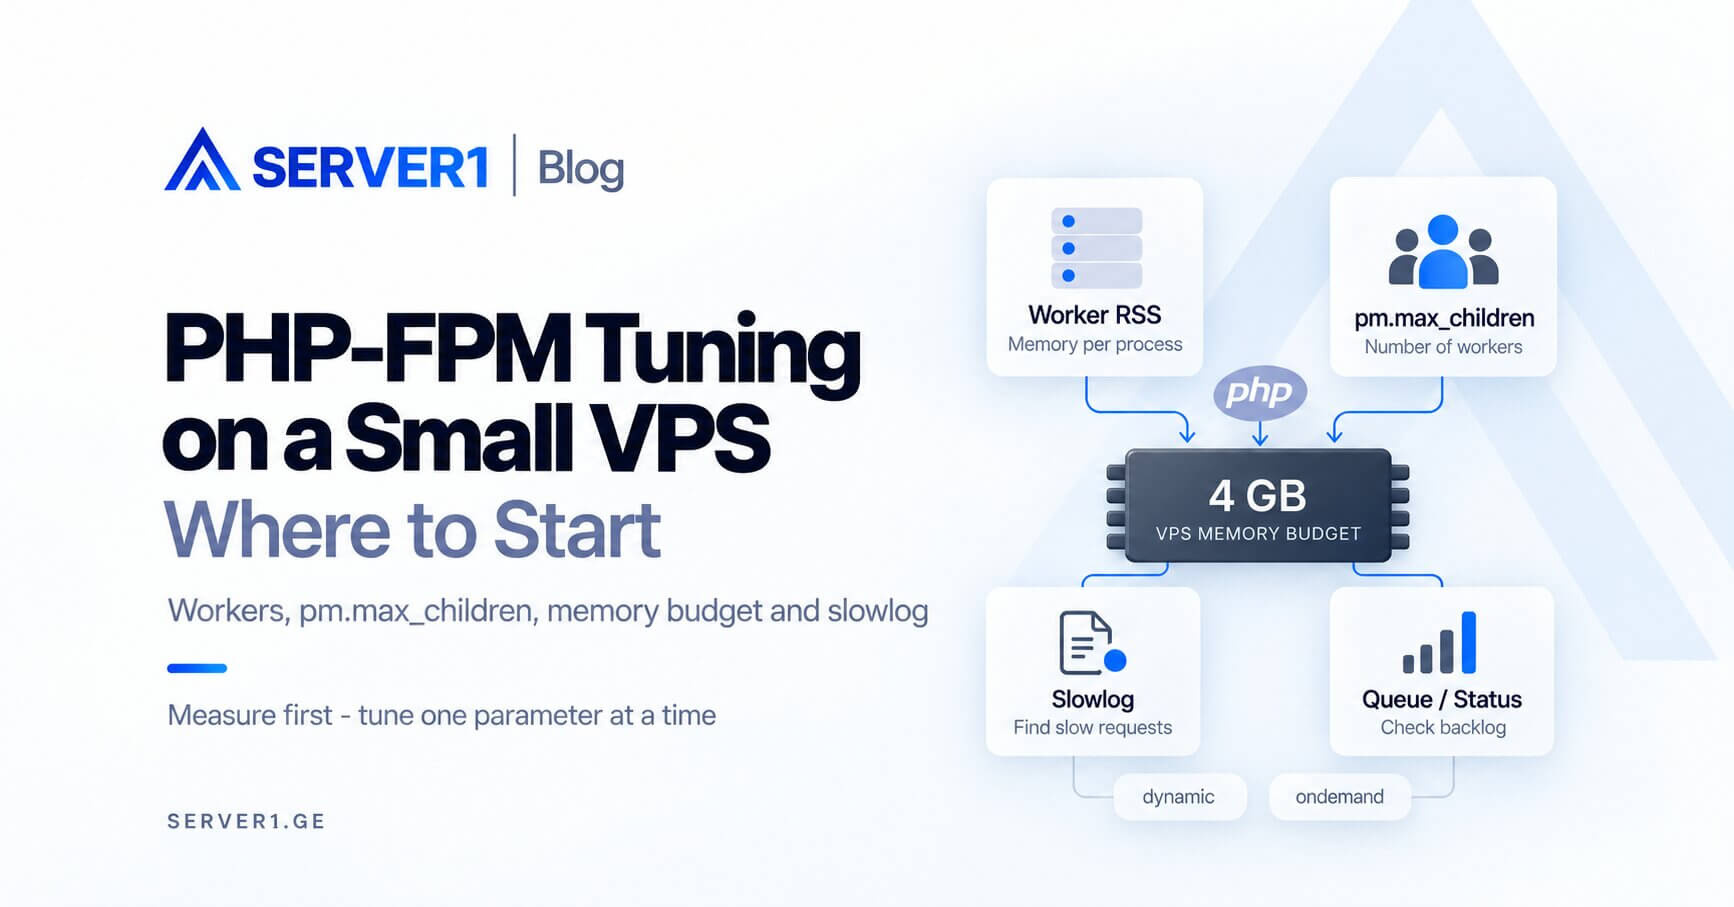
El tuning de PHP-FPM en un VPS pequeño debería empezar con un memory budget, no aumentando `pm.max_children` al azar. La pregunta útil es cuántas solicitudes PHP simultáneas puede mantener el servidor dejando suficiente RAM para la base de datos, el sistema operativo y la caché.
Mide primero un worker real
Observa el RSS de los procesos PHP-FPM con tráfico representativo. Si un worker consume alrededor de 90 MB, veinte workers podrían necesitar aproximadamente 1.8 GB solo para PHP. Es un ejemplo, no una regla universal: mide tu propia aplicación.
Memory budget de trabajo para un VPS de 4 GB
| Componente | Por qué necesita RAM |
|---|---|
| OS + system services | funcionamiento básico y headroom |
| Database | buffers, cache, connections |
| PHP-FPM | worker count × RSS observado |
| Cache / monitoring / panel | overhead adicional permanente |
la guía de optimización de WordPress es útil porque el tuning de workers no arregla un plugin pesado ni una query ineficiente. la guía para elegir un servidor de base de datos ayuda a contabilizar otro gran consumidor de RAM.
dynamic u ondemand?
dynamic
Buen punto de partida para tráfico variable cuando los spare workers y los límites están basados en mediciones.
ondemand
Puede ser útil con tráfico bajo o irregular cuando quieres reducir la memoria consumida por workers inactivos.
Encuentra el límite con mediciones
- mide la peak concurrency;
- observa la duración de las requests;
- vigila la queue y los eventos `max_children reached`;
- comprueba swap, DB latency y CPU al mismo tiempo;
- cambia un parámetro y vuelve a medir.
En VPS no administrado este tuning forma parte de tu propio stack. Si prefieres delegar las operaciones de OS y web stack, compara con Managed VPS y confirma hasta dónde llega el soporte de performance tuning.
Una fórmula sencilla que solo sirve como estimación inicial
Puedes pensar en el límite superior de esta forma:
RAM disponible para PHP ÷ RSS medio observado por worker = número teórico de workers.
No copies ese resultado directamente a `pm.max_children`. Necesitas headroom para traffic spikes, crecimiento de la memoria de la base de datos, OS page cache y requests más caras de lo normal. El límite de producción debería estar por debajo del máximo puramente teórico.
Qué signal apunta a qué problema
| Señal | Posible interpretación |
|---|---|
| `max_children reached` | límite de concurrencia bajo o requests demasiado largas |
| crece la queue con CPU libre | worker limit o blocking operation |
| crece swap | workers, DB y cache superan la RAM |
| CPU saturada y queue creciente | añadir workers puede empeorar la situación |
| unas pocas requests son muy lentas | slowlog/application profiling puede ser más importante |
FPM status y slowlog forman parte del tuning
El tuning no consiste solo en mirar `top`. FPM status puede mostrar workers activos/inactivos, queues y saturation del process manager. Slowlog ayuda a localizar el PHP call path de requests que tardan demasiado.
Un ciclo de tuning de 24 horas
- registra un baseline durante un peak real;
- cambia un solo parameter importante;
- observa un patrón de tráfico comparable;
- compara p95 response time, queue, CPU, RAM y errors;
- haz rollback si el resultado empeora.
El error más común es confundir un capacity problem con un application problem. Si una request tarda tres segundos por una query ineficiente, más workers pueden limitarse a ejecutar más requests lentas al mismo tiempo.